なぜ TypeSafe は、テキスト生成の最適化ではなく、キャリブレーション (較正) された確率を伴う意思決定モデルを訓練するのか、説明します。
Jev 入門 : コンセプト – AI 入門
作成 : クラスキャット・セールスインフォメーション
作成日時 : 10/12/2026
* 本記事は docs.typesafe.ai の以下のページを参考にしています :
* サンプルコードの動作確認はしておりますが、必要な場合には適宜、追加改変しています。
Jev 入門 : コンセプト – AI 入門
なぜ TypeSafe は、テキスト生成の最適化ではなく、キャリブレーション (較正) された確率を伴う意思決定モデルを訓練するのか、説明します。
ほとんどの AI プロダクトは、モデルと人間の間の会話を中心に構築されています。TypeSafe はそれとは別の賭け (異なる見立て) から出発しています: 大規模な自動化においては、AI 同士、あるいは AI とソフトウェアのインタラクションが大半を占めるようになるため、チャットインターフェースよりもマシンインターフェースのほうが重要になるという点です。
私たちはこれを マシンネイティブ・インテリジェンス と呼んでいます :
構造性、信頼性、観測容易性(オブザーバビリティ)、テスト容易性、速度、一貫性、低コストといった、ソフトウェア特有の性質を備えた AI のことです。
(全知全能の) 神 (God) ではなく、プロダクション(prod)を創る
TypeSafe は、何でもできるモデルを構築しようとしているわけではありません。コード側で検証し、それに基づいて次のアクションを実行できるような、狭い (スコープの限定された) 意思決定を必要とする、本番運用向けに設計されています。
私たちは、大規模な AI 自動化においては、マシン間のインタラクションが 99%、人間とのインタラクションが 1% という比率に近づいていくと考えています。そのため、設計の目標は「人間が読んで心地よく感じる応答」から、「ソフトウェアの内部で予測可能な振る舞いをする出力」へとシフトします。
Read the TypeSafe manifesto.
事後学習 (ポストトレーニング) における3つのアプローチ
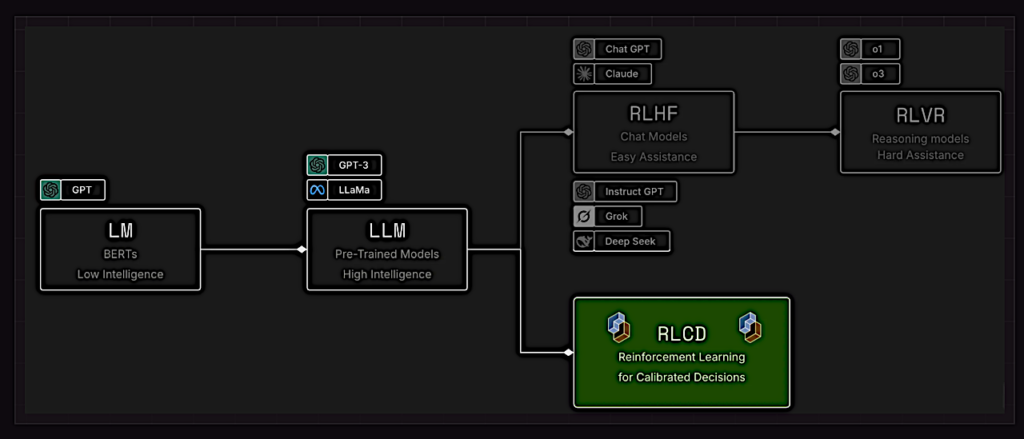
事前学習済み言語モデルの適合 (アダプテーション) には、これまで大きく分けて2つの方法がありました。TypeSafe はそこに3つ目のアプローチを加えます。
ここでは文脈を補足するために RLHF と RLVR を示しています; TypeSafe が採用する学習方針は RLCD です。
- RLHF – 人間のフィードバックによる強化学習 (Reinforcement learning from human feedback) は、事前学習済みモデルをチャットボットへと変貌させました。これは、人間が好む応答を生成するようにモデルを訓練する手法です。
- RLVR – 検証可能な報酬による強化学習 (Reinforcement learning with verifiable rewards) は、数学などのタスクに強い推論モデルを生み出しましたが、その反面、動作は遅くコストも高くなります。
- RLCD – キャリブレーション (較正) された意思決定のための強化学習 (Reinforcement learning for calibrated decisions) は、生成されたテキストの代わりに、意思決定とキャリブレーションされた確率を返すよう TypeSafe を訓練します。
RLHF は InstructGPT や ChatGPT の学習に用いられた手法であり、TypeSafe の共同創業者である Diogo Almeida が共同発明者の一人として名を連ねています。
RLCD とキャリブレーションされた意思決定
RLCD は、従来とは異なる出力の契約 (仕様, contract) に向けて最適化を行います :
- モデルはテキストを生成しません。
- 意思決定と確率を返します。
- 確率が高いほど、その回答が正解である可能性が高くなるように対応している必要があります。
キャリブレーションによって、不確実性はソフトウェアで扱えるものになります。適切にキャリブレーションされたモデルによる多数の予測において :
- 0.2 の確率が割り当てられた結果は、約 20% の確率で発生するはずです。
- 0.8 の確率が割り当てられた結果は、約 80% の確率で発生するはずです。
- 1.0 の確率が割り当てられた結果は、100% 発生するはずです。
これらの割合は予測の母集団を説明するものであり、個々の単一の回答に対する保証ではありません。See Confidence for guidance on deciding when software should act or escalate.
RLHF の問題点
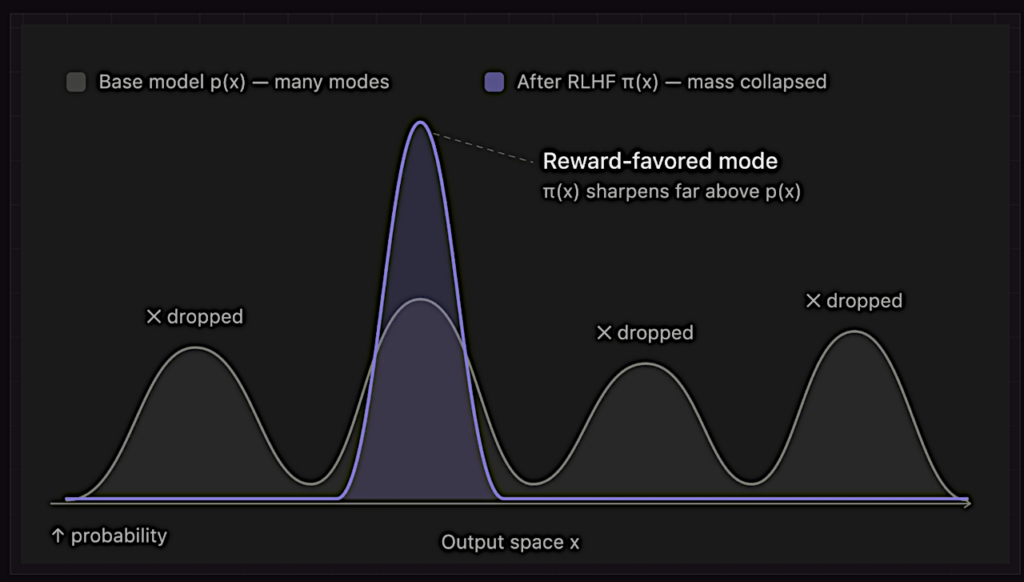
RLHF は、人間が好むような内容を述べるようにモデルを訓練します。その目的はチャットボットにはうまく機能しますが、同時におべっか (追従, sycophancy) や自信ありげに聞こえるハルシネーションを助長してしまうリスクもあります。
また、嗜好最適化 (人間の好みに合わせた最適化) は モードドロップ (mode dropping) も引き起こします: モデルが指示への追従といった特定の出力スタイルを過度に好むようになる一方で、それ以外の出力が得られる確率を低下させてしまう現象です。
⚠️ An output can be compelling to a person without being reliable enough for unattended automation. Human preference and machine trustworthiness are different optimization targets.
以上